El contexto: qué es Traffic OS
Traffic OS es mi aplicación privada e interna para gestionar la publicación de vídeo en YouTube: genera candidatos de contenido, los pasa por revisión, aplica una política antes de publicar y, solo entonces, sube el vídeo. Cada paso que puede tener consecuencias reales — publicar algo, no solo proponerlo — pasa por una aprobación humana explícita. No es un producto público ni algo que venda: es infraestructura que opero yo mismo.
Antes de tener un canario público real, cada candidato solo se había subido en modo validación privada: una subida real a YouTube, pero no visible, pensada para comprobar que el pipeline funciona de principio a fin sin exponer nada todavía. El primer canario público real fue distinto: la primera vez que un candidato salía de verdad, visible, medible.
Qué salió mal
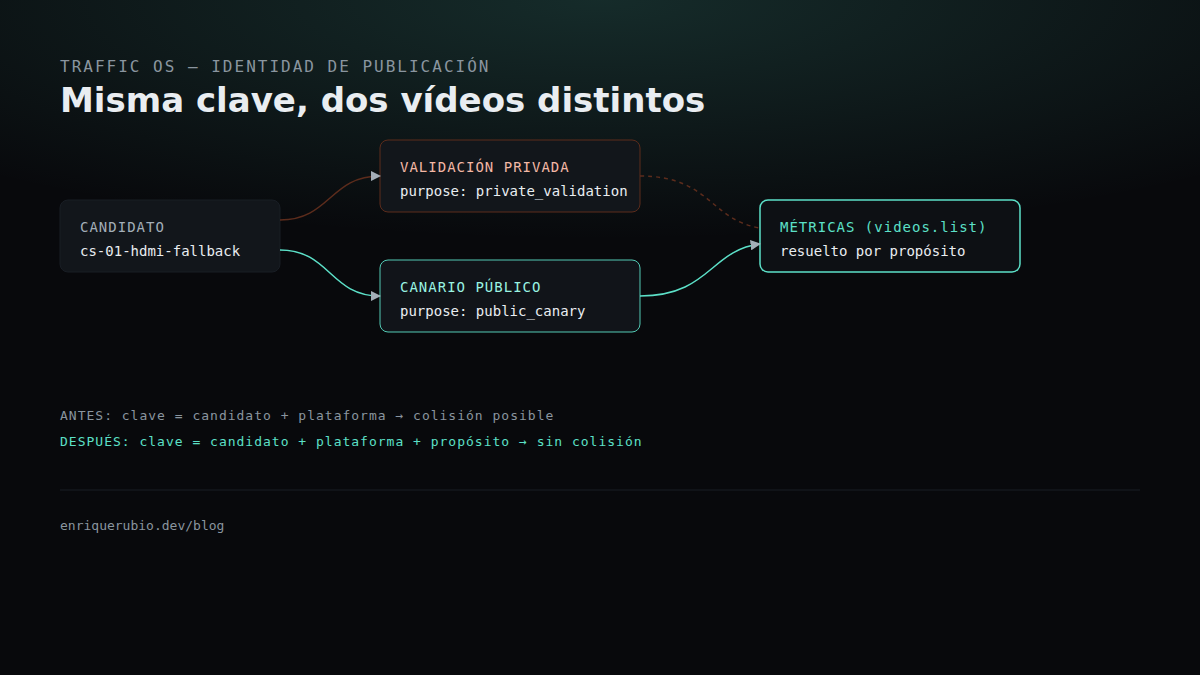
La tabla interna que registra “qué vídeo es el real para este candidato” (la que usan tanto la publicación como la recogida de métricas) identificaba cada publicación solo por candidato + plataforma. No existía una tercera dimensión para el propósito de esa publicación: no distinguía entre “esto es una validación privada” y “esto es el canario público”.
Eso no era un problema mientras cada candidato solo tenía, como mucho, una subida. Pero en cuanto un mismo candidato tuvo dos subidas reales — la validación privada de antes y el canario público nuevo — las dos competían por la misma clave. La ruta de publicación del canario público, además, estaba construida para saltarse el orquestador compartido que normalmente escribe esa tabla, así que no dejó ningún registro nuevo. La fila antigua de la validación privada se quedó como si fuera la publicación “viva” para ese candidato.
El resultado, si hubiera ejecutado la recogida de métricas tal cual: el sistema habría leído las estadísticas del vídeo de validación privada y se las habría atribuido al experimento del canario público. Datos correctos, vídeo equivocado.
Lo detecté porque, al conectar la recogida de métricas contra un canario real por primera vez, los números no encajaban con lo que esperaba para ese vídeo. Nadie había ejercitado esa ruta exacta con una publicación real antes, así que el hueco llevaba ahí desde que se construyó, sin que nada lo hubiera activado.
Cómo lo arreglé
Primero, una reparación manual de los datos ese mismo día: corregir la fila con la evidencia real disponible, sin inventar nada. Eso resolvía el síntoma, no la causa.
La causa se arregló unos días después con un cambio estructural: una migración que añade el propósito de la publicación a la clave de identidad, para que dos vídeos del mismo candidato nunca puedan volver a confundirse.
// Antes
clave_publicación = (candidato_id, plataforma)

// Después
clave_publicación = (candidato_id, plataforma, propósito)
// propósito ∈ { validación_privada, canario_público, ... }
Con la clave ampliada, cada vídeo tiene su propia fila, y la recogida de métricas resuelve exactamente el vídeo que corresponde a cada propósito — nunca el otro. También añadí un test de regresión cuyo propio nombre describe el bug: las métricas resueltas para un propósito no pueden nunca filtrarse hacia otro propósito distinto. Si alguna vez vuelvo a tocar esa lógica, ese test falla antes de que el error llegue a producción otra vez.
Las métricas en sí, para que quede claro, se leen exclusivamente vía videos.list de la YouTube Data API — estadísticas públicas del propio vídeo (vistas, likes, comentarios), no la API de YouTube Analytics. Eso no cambió con este arreglo; lo que cambió fue a qué vídeo se le atribuían.
Qué aprendí
- La parte del sistema que nadie ha ejercitado de verdad es donde se esconden los invariantes rotos. El código existía, tenía buen aspecto, pero nunca se había probado con una publicación pública real hasta ese momento.
- Un identificador incompleto es peor que ningún identificador. Con candidato + plataforma, el sistema parecía funcionar — hasta que dejó de ser cierto que esa clave identificaba una sola cosa.
- Saltarse el camino compartido para un caso “especial” (el canario público, en modo one-shot) es exactamente donde se pierde la contabilidad que todo lo demás da por hecha. La ruta rápida no reutilizaba el punto donde se escribía el registro.
- Un test que nombra el bug, no solo el síntoma, vale más que un test genérico. El test de regresión dice literalmente qué invariante protege, así que si alguien lo rompe en el futuro, entenderá inmediatamente por qué existía.
Cómo lo construiría ahora
Si empezara Traffic OS de cero, la identidad de cada publicación llevaría el propósito desde el primer día — no como algo que se añade cuando aparece el segundo caso real, sino como parte del modelo de datos original. Y cualquier ruta “especial” u “one-shot” pasaría por el mismo punto de registro que todas las demás, en vez de tener su propio atajo. Los atajos son exactamente donde se pierde la invariante que el resto del sistema da por garantizada.
Por qué cuento esto
Publicar contenido de forma automatizada no es “llamar a una API”. Es generación, revisión, política y publicación como capas separadas, cada una con su propia forma de fallar — y la capa donde más confías (la que lleva la cuenta de qué se publicó) es exactamente donde un fallo silencioso hace más daño, porque no rompe nada visible: solo produce datos incorrectos con toda la confianza de datos correctos. Este es el primer incidente real que encontré llevando Traffic OS a producción, y por eso lo cuento con nombres y propósito reales, sin inflar ni suavizar lo que pasó.
Relacionado: otro tipo de rechazo, desde la parte de contenido del mismo sistema, en mi sistema de IA pasó 2 de 3 pruebas para publicar solo.
Fuentes
¿Quieres seguir el proyecto?
Ver Traffic OS