La grabación es la parte barata. El trabajo está en pasar de un archivo en bruto de unos 1,8 GB a un vídeo que yo esté dispuesto a subir a YouTube.
En un artículo anterior conté su primera versión: un agente editor al que llamo Marcos, pensado para clips cortos. Esto es lo que hizo la segunda versión con un trabajo real de formato largo.
El trabajo, en números
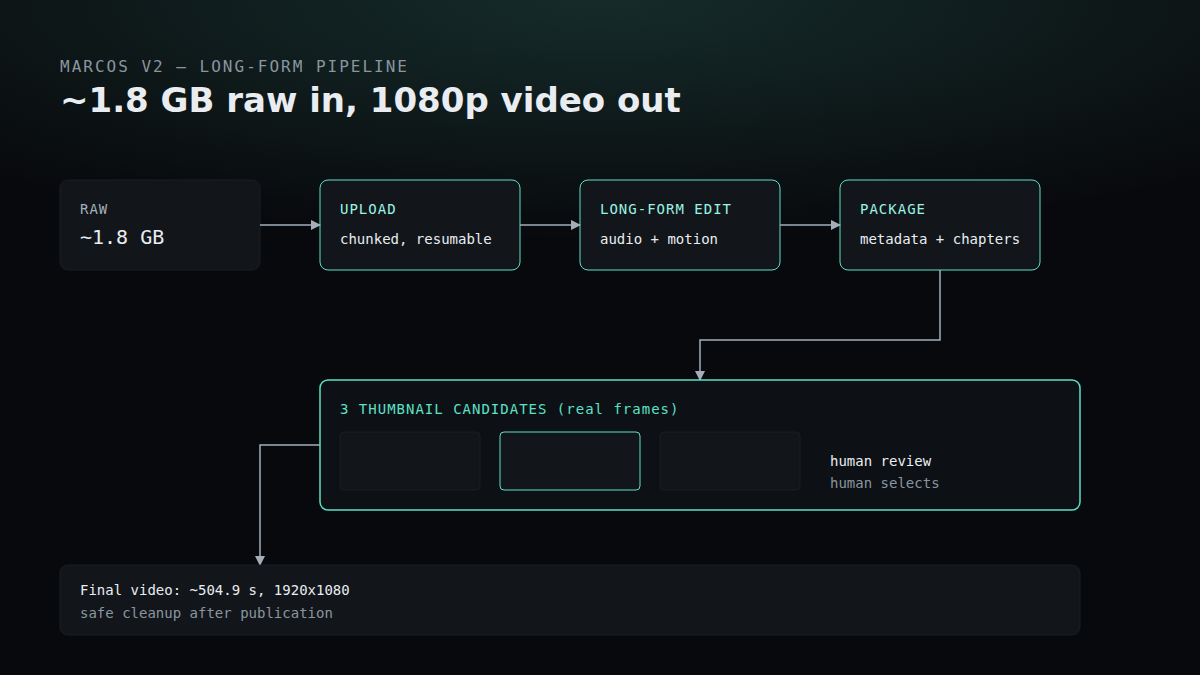
- Entrada: unos 1,8 GB de vídeo en bruto.
- Salida: un vídeo terminado de unos 504,9 segundos (aproximadamente 8 minutos y 25 segundos) a 1920x1080.
- También producido: un paquete de metadatos para YouTube, capítulos y tres candidatas de miniatura.
El trabajo de producción llegó a una V2 terminada, que revisé manualmente y preferí con mucha diferencia.
El problema de ingeniería, paso a paso
1. Llevar 1,8 GB al servidor. Un archivo de varios gigabytes no es una subida de formulario normal. El sistema de subida trabaja por fragmentos y es reanudable, con checksums, cancelación, un paso de finalización idempotente y protecciones de disco y recursos. No se crea ningún trabajo de edición hasta que la subida se finaliza.
2. Formato largo no es formato corto. El sistema nació como herramienta de formato corto. La V2 añade un modo de formato largo en lugar de estirar el corto.
3. Audio. El audio se masteriza.
4. Motion. Se añaden motion graphics a la edición.
5. Todo lo que rodea al vídeo. Un vídeo en YouTube son también sus metadatos, sus capítulos y su miniatura. El sistema genera un paquete de metadatos para YouTube y capítulos, y crea tres candidatas de miniatura a partir de fotogramas reales del propio vídeo. Elijo una y la selección se descarga.
6. Revisión humana. Reviso el resultado antes de publicarlo. El sistema me lleva a un vídeo terminado; no decide que el vídeo es bueno.
7. Limpieza. El pipeline ya puede limpiar de forma segura las copias locales tras la publicación, para que un archivo de origen de varios gigabytes no se quede indefinidamente en el servidor. Esa limpieza se ha validado de extremo a extremo en trabajos de producción desechables; no afirmo que se ejecutara en este trabajo concreto.
Dónde se usa IA y dónde no
No todos los pasos son un modelo de lenguaje, y no llamo «IA» a todo el sistema. La descripción exacta es planificación y razonamiento editorial asistidos por modelos, con procesamiento de medios y validación deterministas.
- Asistido por modelos: interpretar el contenido y la transcripción, las decisiones editoriales y de planificación, generar los metadatos y el empaquetado alrededor del vídeo, y el razonamiento semántico cuando aplica.
- Determinista: la subida reanudable y la gestión de archivos, la ejecución de FFmpeg y el renderizado, el procesamiento y masterización de audio, la composición y el renderizado de motion, el QA técnico y la validación, los checksums y la idempotencia, la limpieza de almacenamiento y el registro del estado de publicación.
No voy a atribuir una llamada a un modelo a ningún paso más pequeño que eso. Lo que decide es una persona: yo reviso el vídeo, elijo la miniatura y apruebo la publicación.
Lo que esto no demuestra
Es un solo trabajo real de formato largo. No es un historial. El sistema no es un editor totalmente autónomo y no digo que lo sea: la revisión y la selección son pasos humanos por diseño, igual que el pipeline del blog sigue con aprobación humana tras superar solo 2 de 3 ejecuciones de la prueba de autonomía.
Lo que sí muestra es que toda la cadena, desde una subida en bruto hasta un vídeo revisado y publicable con sus metadatos y su miniatura, funcionó con una entrada real. Para el proyecto en conjunto, mira el sistema de operaciones de agentes de IA en la página de proyectos.
¿Quieres seguir el proyecto?
Ver el sistema de operaciones de agentes de IA