Actualización, octubre de 2026: este artículo describe el estado del pipeline a 23 de septiembre de 2026. El último párrafo ya está desfasado; mira la actualización del final.
Qué estaba intentando automatizar
Tengo un sistema personal de agentes al que llamo Jarvis — infraestructura privada que opero yo mismo, no un producto. Una de sus piezas automatiza parte de mi pipeline de contenido en redes: un agente al que llamo Pepe propone guiones para Reels bajo tres “sombreros” distintos (una serie técnica, contenido de crecimiento basado en analítica real, y actualidad de IA), yo grabo el vídeo bruto, un agente editor al que llamo Marcos lo edita, y yo confirmo el resultado final desde un panel antes de que se publique. Nada se publica solo: cada paso con consecuencias reales pasa por una confirmación mía explícita, el mismo principio que ya apliqué en Traffic OS.
Cada uno de los tres sombreros de Pepe tiene una regla simple y deliberada: no propongas un guion nuevo de este tipo si el anterior todavía no se ha grabado. Es una salvaguarda contra acumular un backlog de guiones que nadie va a grabar nunca. Para que esa regla funcione, Pepe necesita saber, con datos reales, si el guion anterior ya se grabó.
El síntoma: parecía que simplemente no había contenido nuevo
Durante la ejecución autónoma diaria de Pepe, empecé a ver que el sombrero de “crecimiento” paraba en seco: revisaba el historial, encontraba que su último guion seguía marcado como “planificado” y no proponía nada nuevo. Día tras día, la misma parada. Un par de semanas después, el sombrero de “actualidad de IA” —que hasta entonces generaba una propuesta nueva casi cada día sin problema— empezó a parar también, por el mismo motivo. Los tres sombreros acabaron bloqueados a la vez.
Mi primera hipótesis fue la más obvia: que Marcos había dejado de recibir o procesar vídeos, o que algún cron relacionado con la analítica que alimenta esas propuestas se había caído. Y no iba del todo desencaminado — un cron distinto sí había estado sin escribir datos frescos durante semanas, una coincidencia que al principio pareció confirmar la hipótesis equivocada. Pero cuando ese cron volvió a funcionar y el bloqueo siguió exactamente igual, quedó claro que estaba mirando al sitio equivocado.
Por qué era difícil de detectar
Lo insidioso de este bug es que cada componente, visto por separado, funcionaba exactamente como estaba diseñado:
- Los crons corrían sin error.
- Las reglas de bloqueo de Pepe hacían justo lo que debían hacer: negarse a proponer contenido nuevo sin confirmación de que el anterior se había grabado.
- Yo sí estaba grabando y confirmando vídeos con normalidad durante todo ese tiempo.
El problema no era que algo estuviera roto y fallando de forma visible. Era que un dato que todo el sistema daba por bueno —“¿ya se grabó el guion anterior?”— llevaba semanas sin actualizarse, y nadie tenía motivo para sospecharlo porque nada devolvía un error. Un sistema puede estar operativamente sano y aun así tener su máquina de estados completamente atascada.
El lifecycle: Marcos → content_calendar → Pepe
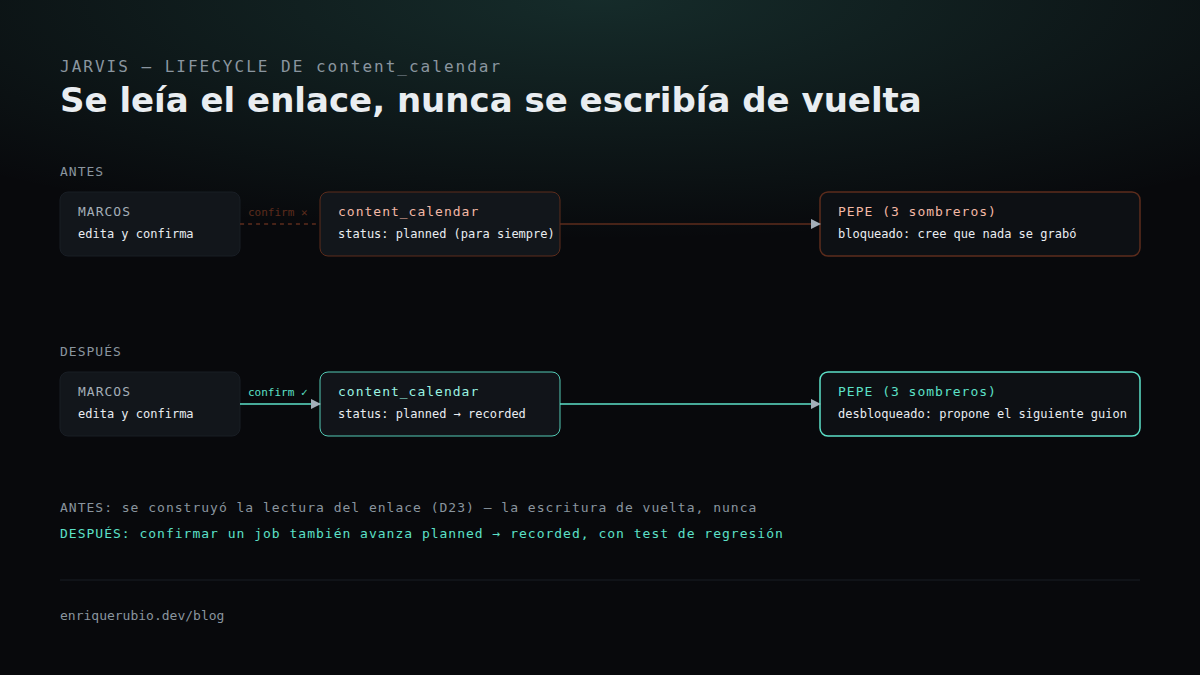
El enlace entre “lo que Pepe propone” y “lo que Marcos edita” pasa por una tabla, content_calendar, con un campo de estado que avanza de planned a recorded (y más adelante a published). Cuando subo un vídeo bruto vinculado a uno de los guiones de Pepe, ese job de edición queda enlazado a su fila de content_calendar mediante un identificador compartido. Marcos, al procesar el job, lee esa fila para saber qué guion y qué indicaciones de edición corresponden a ese vídeo concreto.
Ese enlace de lectura se construyó en un cambio anterior del sistema, semanas antes de que apareciera este bug: Marcos ya sabía leer la fila de content_calendar correspondiente a un job. Lo que nunca se construyó fue la mitad de vuelta.
Qué faltaba realmente
Cuando yo confirmaba un job terminado desde el panel —el punto donde le digo al sistema “este vídeo está listo, dalo por bueno”— ese endpoint marcaba el job como confirmado en su propia tabla, pero ningún código tocaba la fila enlazada de content_calendar. Su estado se quedaba en planned para siempre, aunque el vídeo ya estuviera grabado, editado y confirmado por mí.
Así que las reglas de bloqueo de Pepe estaban haciendo exactamente lo que debían: leer si el guion anterior ya se había grabado. El problema es que esa lectura siempre devolvía “no”, incluso cuando la respuesta real llevaba semanas siendo “sí”.
// Antes
PATCH /jobs/{id}/confirm
  → marca el job confirmado
  → content_calendar.status
    se queda en "planned"
    para siempre

// Después
PATCH /jobs/{id}/confirm
  → marca el job confirmado
  → si hay fila enlazada
    y sigue "planned":
      status = "recorded"
    (nunca degrada una fila
    ya "published"/"archived")
Cómo lo corregí
El fix en sí es pequeño: el endpoint de confirmación ahora también actualiza la fila enlazada de content_calendar, con dos guardas explícitas — solo avanza planned → recorded, nunca retrocede una fila que ya esté published o archived, y no hace nada si el job no tiene una fila enlazada.
Lo que no fue pequeño fue la batería de tests de regresión: cinco casos que verifican que confirmar un job avanza correctamente el estado enlazado, que un job sin enlace no toca nada, que una fila ya publicada nunca se degrada, que el endpoint sigue exigiendo que el vídeo esté descargado antes de aceptar la confirmación, y que confirmar dos veces el mismo job es idempotente y no rompe nada. Los verifiqué contra una base de datos Postgres desechable, nunca contra la base de datos real — el mismo criterio que uso para cualquier test que escriba datos.
Cómo reparé el estado histórico
El fix evita que el bug vuelva a ocurrir, pero no corrige las filas que ya se habían quedado atascadas mientras estuvo presente. Para eso hizo falta un backfill de una sola vez, ejecutado directamente contra producción dentro de una transacción: un UPDATE que solo toca las filas de content_calendar en estado planned cuyo job de vídeo enlazado esté realmente terminado y confirmado — calculado con un JOIN contra los datos reales de esos jobs, no una lista de IDs escrita a mano.
El resultado fueron seis filas reales que pasaron de planned a recorded. Después del backfill verifiqué el estado completo de la tabla con una consulta de solo lectura: el resto de entradas en planned seguían así porque genuinamente no tenían un job confirmado detrás — backlog real de grabación pendiente, no un residuo del bug.
Qué aprendí sobre pipelines de agentes
La lección principal no es “cuidado con los bugs de base de datos” — es más específica que eso: cualquier enlace de lectura entre dos partes de un pipeline necesita su mitad de escritura probada explícitamente, no asumida. Es fácil construir el lado que consume un dato (Marcos leyendo la fila enlazada) y dar por hecho que en algún momento, en algún otro punto del sistema, alguien se encargó de mantenerlo actualizado. Nadie lo había hecho.
La segunda lección es sobre las propias salvaguardas: una regla de bloqueo que hace exactamente lo que se le pidió —no avances sin confirmación— es tan buena como el dato que lee. Si ese dato puede quedarse obsoleto sin que nada lo note, la regla deja de proteger y empieza a bloquear por motivos equivocados, y lo hace de forma silenciosa: no hay ningún error que capturar, solo un pipeline que deja de avanzar.
Y la tercera es sobre el diagnóstico: la coincidencia de un cron de analítica caído en paralelo casi me llevó a “arreglar” lo que no era la causa real. Antes de aceptar la primera explicación que encaja con los síntomas, vale la pena comprobar si de verdad predice todo lo observado — en este caso, seguía sin explicar por qué el bloqueo continuó exactamente igual después de que ese cron se recuperara.
Cómo evitaría este tipo de fallo ahora
Dos cambios concretos que me llevo de esto. Primero: cuando construya cualquier enlace de una sola dirección entre dos tablas o dos pasos de un pipeline, escribo el test de la mitad de escritura en el mismo cambio que el de lectura, aunque esa escritura “vaya a añadirse después” — ese “después” es exactamente el hueco que aquí duró semanas sin que nadie lo notara. Segundo: para cualquier regla de bloqueo automática que dependa de un estado leído de otra tabla, quiero una comprobación periódica independiente que audite si ese estado se mueve alguna vez, no solo que la regla en sí funcione — un bloqueo permanente sobre datos obsoletos y un bloqueo correcto sobre backlog real se ven idénticos desde fuera, y solo una auditoría del dato subyacente distingue uno de otro.
Todavía queda una validación pendiente que no puedo forzar desde el código: la próxima vez que confirme un job real enlazado a una entrada planned, ese será el primer caso end-to-end del fix funcionando en producción con datos reales, no solo con los tests de regresión. Hasta entonces, esto queda verificado por tests y por el backfill, pero no por una confirmación real de Marcos aún por llegar.
Actualización, octubre de 2026
El párrafo anterior es el estado de las cosas en septiembre. Se conserva tal como estaba.
Desde entonces, el pipeline ha llevado un trabajo real de formato largo, unos 1,8 GB de vídeo en bruto, hasta un vídeo terminado en 1080p: el recorrido está aquí. Es una ejecución con datos reales del pipeline en conjunto. No he verificado el write-back planned a recorded por separado, así que la validación concreta con la que terminé sigue abierta. Y el pipeline sigue sin publicar solo: la parte del blog sigue con aprobación humana, a propósito.
Fuentes
¿Quieres seguir el proyecto?
Cómo diseño sistemas de agentes IA