Qué ha pasado
OpenAI publicó recientemente el caso de Ringg, una startup india de agentes de voz que automatiza soporte al cliente por teléfono, chat y WhatsApp. La cifra que encabeza el anuncio: hasta el 65% de las consultas rutinarias se resuelven sin que intervenga ningún humano, sobre un volumen de más de 7 millones de llamadas conectadas al mes.
Ringg no es una startup nueva ni un experimento de laboratorio. Nació como DesiVocal, una herramienta de texto a voz, antes de convertirse en una plataforma de agentes conversacionales. En agosto ya había cerrado una Serie A de 15,5 millones de dólares (con Peak XV Partners liderando la ampliación) y trabaja con clientes reales de peso en India — Practo, Groww, Policybazaar, Flipkart —, algunos con volúmenes de más de mil reservas de cita al día.
Lo que realmente cambia: reparto de modelos por tarea, no un modelo único
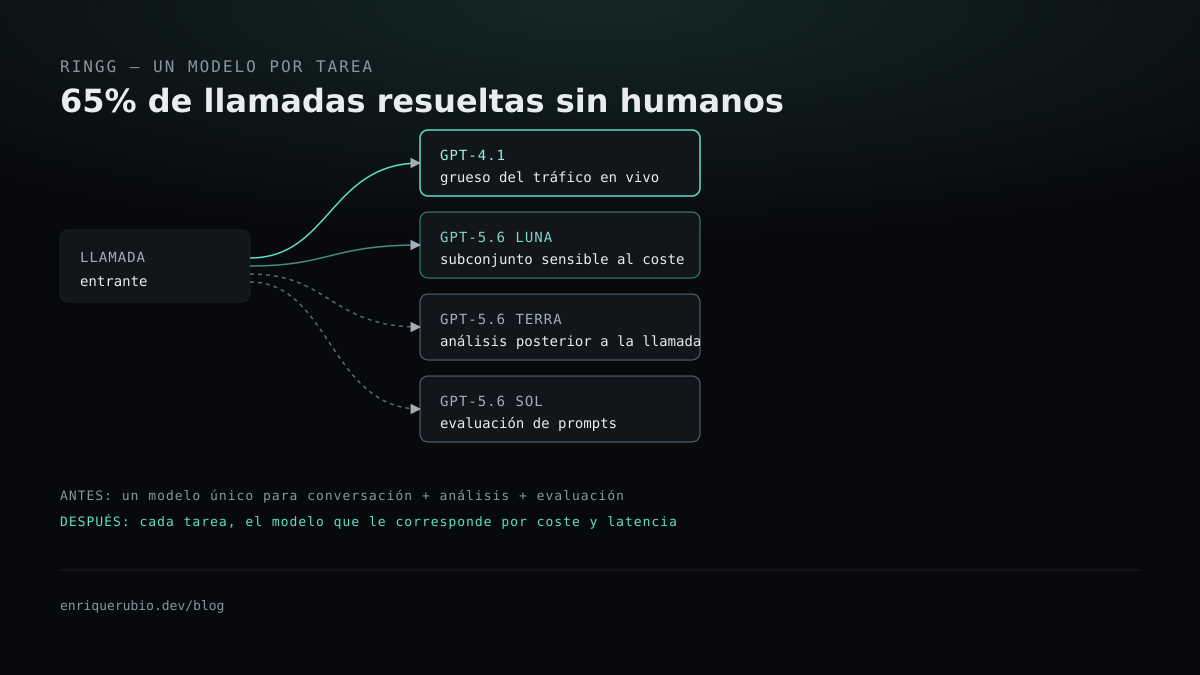
Lo más interesante del caso no es el 65%, sino cómo está construido. Ringg no usa un único modelo para todo el pipeline — reparte el trabajo entre cuatro:
- GPT-4.1 gestiona el grueso del tráfico de voz y chat en vivo — el modelo por defecto para la conversación en tiempo real.
- GPT-5.6 Luna entra en un subconjunto de ese tráfico en tiempo real, específicamente donde el coste importa más que la capacidad máxima — y ahí, según la propia OpenAI, el cambio recorta el coste de modelo en torno a un 90% para esas cargas concretas.
- GPT-5.6 Terra analiza las llamadas ya terminadas — no conversa, resume y clasifica después del hecho.
- GPT-5.6 Sol se usa para evaluar y mejorar los propios prompts del sistema, cerrando el ciclo.
Es una arquitectura de “un modelo por trabajo” en lugar de “un modelo para todo”, y es la parte de este caso con valor real para cualquiera que esté construyendo automatización con LLMs: no hace falta elegir un único modelo y forzarlo a cubrir conversación en vivo, análisis por lotes y evaluación a la vez. Cada tarea tiene un perfil de coste y latencia distinto, y tratarlas por separado es lo que permite bajar el coste sin tocar la calidad donde de verdad importa — la conversación en vivo con el cliente.
Los números por cliente
OpenAI y la cobertura posterior desglosan tres casos concretos:
- Policybazaar: 67% de las llamadas gestionadas sin humano; el tiempo de respuesta bajó de 8-12 minutos a menos de 60 segundos.
- Practo: 85% de resolución en la primera llamada, respuesta en menos de 3 segundos, 70% menos coste operativo frente al flujo anterior liderado por personas, y más de 1.000 reservas de cita diarias gestionadas por el sistema.
- Groww: 72% de resolución en autoservicio para consultas sobre IPOs, futuros y opciones, con un tiempo medio de gestión de unos 2 minutos.
La parte que hay que leer con cuidado
Aquí está el matiz que la propia cobertura señala y que merece la pena repetir: Ringg no explica públicamente cómo decide qué es una consulta “rutinaria”. Y si se miran los tres casos de cliente de arriba, cada uno reporta una métrica distinta — “gestionado sin humano” (Policybazaar), “resolución en primera llamada” (Practo), “autoservicio” (Groww). Son formas de medir relacionadas, pero no intercambiables, y ninguna de las tres es exactamente el “65% de consultas rutinarias” del titular.
Esto no invalida los números — probablemente son reales, y las mejoras de tiempo de respuesta y coste operativo son verificables independientemente de cómo se defina “rutinaria”. Pero sí es la razón por la que comparar la cifra de Ringg con la de cualquier otro proveedor de agentes de voz (y hay varios anunciando cifras similares estos meses) es, por ahora, comparar peras con manzanas. Es el mismo problema que ya se ve en cualquier sector donde una métrica de “automatización” se convierte en titular de marketing sin una definición pública y auditable detrás.
Qué vigilar a partir de aquí
Dos cosas concretas: si Ringg (u otro proveedor del mismo espacio) publica alguna vez una definición operativa de “rutinaria” que permita comparar peras con peras, y si el patrón de reparto de modelos por tarea — en lugar de un modelo único para todo el pipeline — se convierte en la forma estándar de construir este tipo de sistemas, en vez de en un detalle de un único caso de estudio.
Por qué importa
No hace falta trabajar en India ni en atención al cliente para que esto sea relevante. Es un ejemplo concreto y con clientes reales de un patrón que cualquiera construyendo automatización con IA se va a encontrar antes o después: separar por tarea qué modelo usar, en vez de forzar uno solo a hacerlo todo, es lo que hace que el coste baje sin que la calidad de la parte que el cliente realmente experimenta — la conversación — se resienta.