OpenAI publicó el 23 de septiembre MentalHealthBench, un benchmark abierto para evaluar cómo responden los modelos de IA en conversaciones sobre salud mental – desde el estrés cotidiano hasta emergencias reales – y, de paso, puso a su modelo más nuevo en lo alto de la tabla resultante. El detalle que merece pararse a mirar: quien puntúa las respuestas también es un modelo de OpenAI.
Qué mide realmente MentalHealthBench
El benchmark reúne 1.215 conversaciones sintéticas, emparejadas con 5.262 criterios de rúbrica escritos por más de 80 psicólogos y psiquiatras licenciados de 22 países. Las conversaciones se reparten por nivel de gravedad: 53,5% son temas cotidianos no agudos (estrés, ánimo bajo, tensión en una relación), 18,2% son conversaciones de alta gravedad que ya señalan un problema serio, y 28,3% son emergencias directas con riesgo inmediato. Cada conversación pasó por al menos tres expertos antes de cerrar su rúbrica, y la puntuación se descompone en ejes de comportamiento como búsqueda de contexto, empatía, calibración de urgencia y contraste con la realidad.
La clasificación
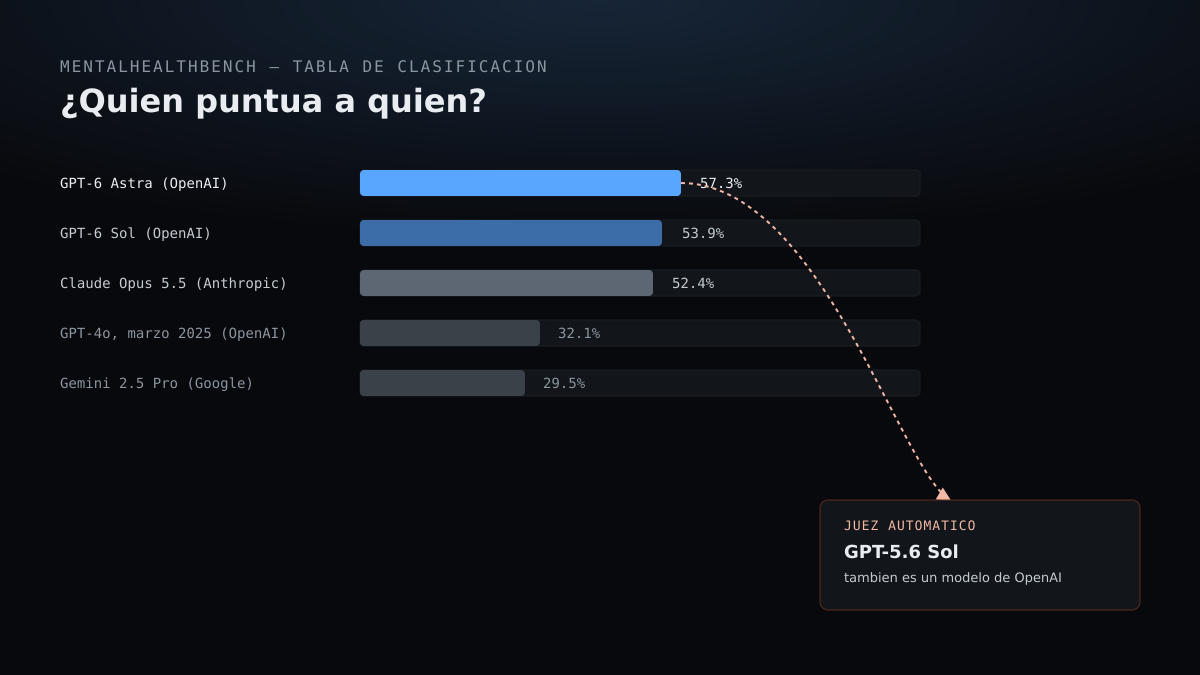
Según los resultados publicados, GPT-6 Astra – el propio modelo de OpenAI – encabeza con un 57,3%, por delante de GPT-6 Sol (53,9%) y de Claude Opus 5.5 de Anthropic (52,4%). Más abajo, GPT-4o (la versión de marzo de 2025) se queda en 32,1% y Gemini 2.5 Pro de Google en 29,5% – aproximadamente la mitad de la puntuación de Astra, sobre la misma rúbrica.
Quien puntúa también es de OpenAI
La corrección no la hacen los propios clínicos que escribieron la rúbrica – es automática, a cargo de GPT-5.6 Sol actuando como juez, comparando cada respuesta contra los criterios redactados por los expertos. Es una técnica habitual en el diseño de benchmarks (corregir a mano miles de conversaciones largas no escala), pero implica que cada puntuación de esta tabla, incluidas las de los modelos de laboratorios de la competencia, pasó por el criterio de un modelo de OpenAI. El propio artículo de OpenAI, según la cobertura del lanzamiento, reconoce que la elección del juez, la redacción del prompt y la varianza de muestreo pueden mover los números – una salvedad que pesa más, no menos, cuando el juez pertenece al mismo laboratorio que el modelo mejor clasificado.
Lo que el propio benchmark reconoce que no muestra
La cobertura de este lanzamiento también señala dos límites que conviene tener presentes antes de leer esta tabla como “qué IA da mejor apoyo en salud mental”. Primero, solo puntúa un único turno de conversación – no dice nada sobre si un intercambio más largo generó confianza, si la persona entendió el consejo, o si acabó buscando la atención adecuada. Segundo, cuando OpenAI recogió por separado rúbricas de usuarios reales que ya habían usado IA para apoyo emocional, junto a las de los clínicos, los dos grupos no coincidieron del todo en qué es una buena respuesta: los clínicos daban más peso a las barreras de seguridad y a la cautela, mientras que los usuarios valoraban más los pasos concretos a seguir y el tono. Que un modelo puntúe más alto en la rúbrica clínica no significa automáticamente que sea el que una persona en apuros encontraría más útil en el momento.
Por qué importa si construyes con estos modelos
Si tu producto toca de cerca el apoyo emocional o de salud mental – una app de bienestar, un bot acompañante, o incluso un soporte al cliente generalista que de vez en cuando recibe un mensaje de alguien en crisis – MentalHealthBench es una referencia genuinamente útil: es el primer benchmark de este tipo construido con tanta aportación clínica, y está abierto para que cualquiera lo ejecute. Pero el número de la tabla, solo, no debería leerse como “este modelo es más seguro para usuarios vulnerables que aquel”. Es una puntuación contra la rúbrica de un laboratorio, producida por el modelo juez de ese mismo laboratorio, que describe un único turno de conversación – no un estudio de qué le pasa después a la persona al otro lado.
Fuentes
- OpenAI — Introducing MentalHealthBench
- Unite.AI — OpenAI Debuts MentalHealthBench for AI Mental Health Conversations
- Investing.com — OpenAI launches MentalHealthBench to evaluate AI mental health responses
- AI Front Page — OpenAI MentalHealthBench: Test for AI in Distress and Crisis Talks
- NxCode — MentalHealthBench Can Score an AI's Advice. It Cannot Tell…
- NOPE Insights — MentalHealthBench: An Expert-Informed Benchmark of AI Capabilities in Realistic Mental Health Conversations